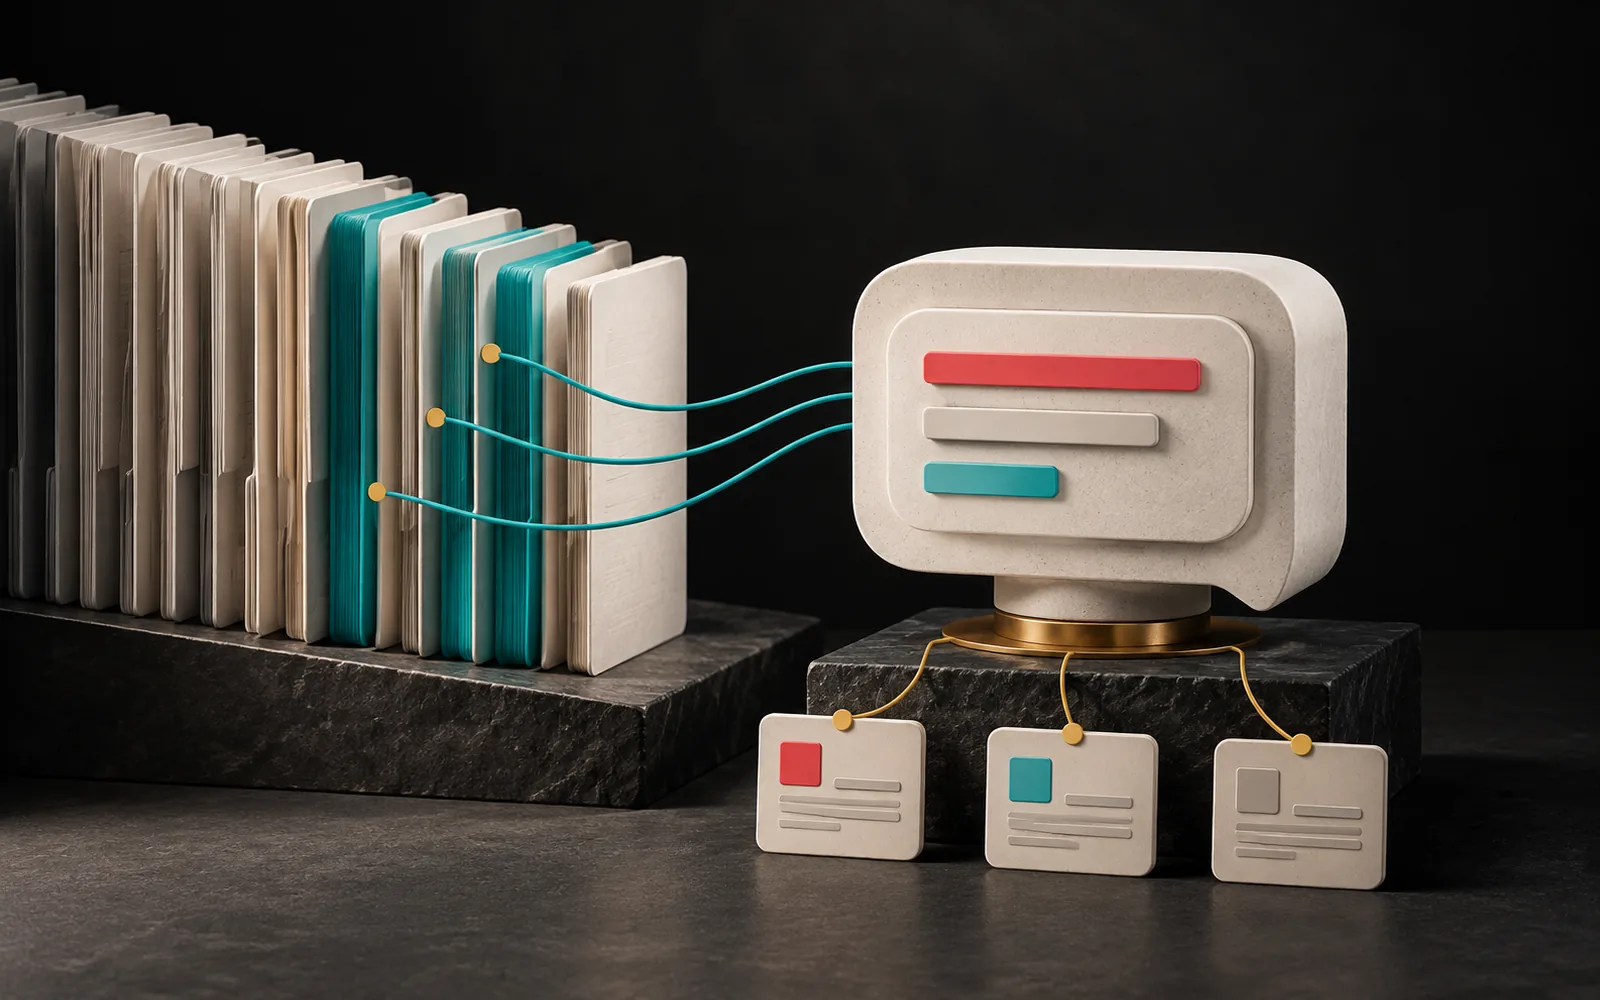
RAG (Retrieval-Augmented Generation, Türkçesiyle "getirme destekli üretim"), bir yapay zeka modelinin soruyu cevaplamadan önce sizin belgelerinizde arama yapması ve cevabını bulduğu ilgili parçalara dayandırması yöntemidir. Yani modeli yeniden eğitmezsiniz. Ona her soruda doğru bilgi "önüne konur". Bu yüzden RAG, şirket içi prosedürler, ürün kılavuzları ya da sık sorulan sorular gibi kurumsal bilgiyle çalışan asistanlar için çoğu zaman ilk akla gelen yöntemdir. Bu yazıda RAG nedir, ince ayardan (fine-tuning) farkı nedir ve kendi verinizi kullanırken KVKK açısından nelere dikkat etmelisiniz, sırayla anlatıyoruz.
Kısaca
- LLM genel bilgiyle eğitilmiş bir dil modelidir. Sizin şirketinize özel bilgiyi kendiliğinden bilmez.
- RAG, soruyla ilgili belge parçalarını bulup modele cevap sırasında verir. Belgeyi güncellemek, bilgiyi güncellemek için yeterlidir.
- İnce ayar (fine-tuning) modelin davranışını, biçimini ve tonunu tutarlı hale getirmek için daha uygundur. Yeni ve sık değişen bilgi için genelde RAG tercih edilir.
- RAG halüsinasyonu azaltabilir ama sıfırlamaz. Kötü ya da eski belge, kötü cevap demektir.
- Kişisel veri içeren belgelerde erişim yetkisi, yurt dışına aktarım ve silme talepleri baştan tasarlanmalıdır.
Temel kavramlar
LLM (büyük dil modeli): Çok büyük miktarda metinle eğitilmiş, metni anlayıp üretebilen model. Eğitim verisinde olmayan bilgiyi (sizin fiyat politikanız, iç prosedürünüz, geçen hafta güncellenen kılavuzunuz) bilmez. Bilmediği yerde makul görünen ama yanlış bir cevap üretebilir. Buna "halüsinasyon" denir.
Bağlam (context): Modele bir soruyla birlikte verilen metin. Model, cevabını hem eğitimden gelen bilgisine hem de bu bağlama dayanarak üretir. RAG'in temel fikri, doğru bağlamı otomatik olarak bulup vermektir.
Embedding (vektör temsili): Bir metnin anlamını sayılardan oluşan bir diziye dönüştürme yöntemi. Anlamca birbirine yakın metinlerin sayısal temsilleri de birbirine yakın olur. Böylece "fatura iadesi nasıl yapılır?" sorusu, içinde aynı kelimeler geçmese bile "iade edilen ürünlerde belge süreci" başlıklı bir paragrafla eşleşebilir.
Vektör veritabanı: Bu sayısal temsilleri saklayan ve "bu soruya anlamca en yakın parçalar hangileri?" sorusunu hızlıca cevaplayan veritabanı.
İnce ayar (fine-tuning): KVKK'nın üretken yapay zeka rehberindeki tanımıyla, bir temel modelin belirli bir görev için gözetimli öğrenme yoluyla daha fazla eğitilmesi. Yani modelin kendisi değişir.
RAG fikri yeni değil. Terim, 2020'de Patrick Lewis ve arkadaşlarının yayımladığı "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks" makalesiyle yaygınlaştı. Makale, modelin parametrelerinde saklı bilgiyi dışarıdaki aranabilir bir belge diziniyle birleştirmeyi öneriyordu.
RAG nasıl çalışır?
RAG iki aşamadan oluşur.
Hazırlık (bir kez ve belgeler değiştikçe):
- İlk olarak belgeleri toplarsınız: PDF kılavuzlar, prosedürler, SSS, ürün sayfaları.
- Ardından belgeleri anlamlı parçalara bölersiniz (ör. başlık ya da paragraf bazında).
- Her parçanın embedding'i hesaplanır ve vektör veritabanına kaydedilir. Parçanın hangi belgeden geldiği ve kimlerin görebileceği gibi bilgiler de yanında tutulur.
Soru anı (her soruda):
- Sistem kullanıcının sorusunu da embedding'e çevirir.
- Sonra veritabanında soruya en yakın parçaları bulur. Bu sırada kullanıcının görmeye yetkili olmadığı parçaları eler.
- Bulunan parçalar soruyla birlikte modele verilir: "Yalnızca aşağıdaki bilgilere dayanarak cevap ver, emin değilsen bilmediğini söyle."
- Model cevabı üretir. İyi bir sistem, cevabın hangi belgelere dayandığını da gösterir.
RAG mi, ince ayar mı?
OpenAI'ın model doğruluğunu artırma rehberi, iki yöntemi farklı sorunların çözümü olarak konumlandırıyor:
- Model bilgiden yoksunsa (bilgi eski, şirkete özel ya da sık değişiyorsa) bağlamı iyileştirmek, yani RAG gibi yöntemler uygundur.
- Model bilgiye sahip ama işi tutarsız yapıyorsa (yanlış biçim, değişken ton, adımları atlama) ince ayar uygundur. Amaç, davranışın tutarlılığıdır.
- Ancak ikisi birbirinin alternatifi değildir. Gerektiğinde ikisini birlikte kullanabilirsiniz.
| Soru | RAG | İnce ayar (fine-tuning) |
|---|---|---|
| Ne değişir? | Modele verilen bağlam | Modelin kendisi |
| En uygun olduğu durum | Şirkete özel, güncel ya da sık değişen bilgi | Sabit bir biçim, ton ya da görev davranışı |
| Bilgiyi güncellemek | Belgeyi güncelleyip yeniden indekslemek | Yeniden eğitim gerekir |
| Kaynak gösterme | Kolay: cevap belirli parçalara dayanır | Zor: bilgi modelin içine dağılmıştır |
| Erişim yetkisi | Belge ya da parça bazında uygulanabilir | Modele girdikten sonra yetkiyle ayırmak zordur |
| Veri silme | Belgeyi ya da parçayı dizinden silmek mümkündür | Modelden bilgiyi "unutturmak" hâlâ araştırma konusudur |
| Hazırlık emeği | Belge düzeni ve arama kalitesi | Kaliteli eğitim örnekleri ve değerlendirme |
Tablodaki "unutturma" satırı özellikle önemli. Makine öğrenmesinde "unlearning" üzerine 2025'te yayımlanan kapsamlı bir derleme çalışma, bazı yöntemlerin bilgiyi gerçekten silmek yerine yalnızca modelin davranışını bastırıyor olabileceğini ve silmenin doğrulanmasının hâlâ açık bir sorun olduğunu belirtiyor. Bu yüzden kişisel veriyi silmeniz gerekebilecek durumlarda RAG daha yönetilebilir kalır.
RAG'in sınırları
RAG güçlü bir yöntem ama sihirli değil:
- Belge kalitesi: Çelişkili, eski ya da eksik belgeler varsa sistem bunları güvenle aktarır. RAG, bilgi düzensizliğini çözmez, görünür kılar.
- Arama hatası: Sistem doğru parçayı bulamazsa model eksik bağlamla cevap verir. Parçalama ve arama ayarları sonuç kalitesini doğrudan etkiler.
- Halüsinasyon tamamen bitmez: Model, verilen parçalarda olmayan bir bilgiyi yine de ekleyebilir. Kaynak gösterme ve "bilmiyorum" diyebilme önemlidir.
- Belgelerdeki gizli talimatlar: OWASP, RAG ve ince ayarın prompt injection riskini tamamen ortadan kaldırmadığını belirtiyor. Bilgi tabanına giren bir belgedeki gizli metin, modelin davranışını etkileyebilir. Belgeleri güvenilir kaynaklardan almak ve sisteme girmeden önce kontrol etmek gerekir.
- Vektör veritabanı riskleri: OWASP'ın 2025 listesinde vektör ve embedding zayıflıkları ayrı bir başlık. Öne çıkan riskler: zayıf erişim kontrolüyle yetkisiz veri sızıntısı, aynı veritabanını paylaşan farklı grupların birbirinin verisine erişmesi ve bilgi tabanına kasıtlı olarak bozuk veri eklenmesi. Bu nedenle önerilen önlemlerin başında, yetkiye duyarlı arama ve verinin mantıksal olarak ayrılması geliyor.
Veri gizliliği ve KVKK
Kurumsal bilgi tabanınızda müşteri yazışmaları, personel bilgileri ya da servis kayıtları varsa, RAG sistemi kişisel veri işliyor demektir. KVKK'nın Kasım 2025'te yayımladığı üretken yapay zeka rehberinden ve genel ilkelerden çıkan başlıca noktalar:
- Kanun kapsamı: Üretken yapay zeka sistemleriyle yapılan kişisel veri işleme 6698 sayılı Kanun kapsamındadır. Hukuka uygunluk, doğruluk, amaçla sınırlılık ve ölçülülük gibi genel ilkeler burada da geçerlidir.
- Veri minimizasyonu: Bilgi tabanına yalnız amaç için gereken belgeleri alın. Bir ürün SSS asistanının müşteri yazışmalarına erişmesine gerek yoktur. Mümkünse kişisel verileri belgelerden ayıklayın ya da anonimleştirin.
- Yurt dışına aktarım: Embedding hizmeti, vektör veritabanı ya da dil modeli yurt dışında bir sağlayıcıda çalışıyorsa ve kişisel veri oraya gidiyorsa, rehberin de vurguladığı gibi bu aktarım Kanun'un 9. maddesine ve Temmuz 2024'te yayımlanan yurt dışına aktarım yönetmeliğine uygun olmalıdır. Bulut hizmetlerinin genel mantığını bulut bilişim yazımızda anlatmıştık.
- Aydınlatma: Rehber, bir yapay zeka sistemini kullanmak için yapılan işleme ile sistemi ve modelleri geliştirmek için yapılan işlemenin ayrı ve açık biçimde aydınlatılmasını öneriyor.
- Roller: Hizmet sağlayıcının sizin adınıza veri işleyen mi, yoksa kendi amaçları için veri sorumlusu mu olduğu her veri işleme faaliyeti için ayrı değerlendirilmelidir. Sözleşmede, verilerinizin sağlayıcının modellerini eğitmek için kullanılıp kullanılmadığını kontrol edin.
- Doğruluk ve silme: Eski ya da hatalı bilgi içeren belgeler güncellenmeli, saklama süresi dolan veriler silinmeli ya da anonimleştirilmelidir. RAG'de bu, belgenin dizinden de kaldırılması anlamına gelir.
- Kayıt ve güvenlik: Kimin hangi soruyu sorduğu ve hangi belgelere erişildiği kayıt altına alınmalı. Bu kayıtların kendisi de kişisel veri içerebileceği için korunmalıdır.
Yazılım tarafındaki genel ilkeleri KVKK uyumlu yazılım geliştirme yazımızda ayrıntılı olarak ele almıştık.
Kurumsal bilgi tabanı için nereden başlamalı?
- Tek bir kullanım senaryosu seçin. Örneğin "teknik servis ekibinin ürün kılavuzlarından cevap bulması".
- Belgeleri toplayın ve temizleyin. Eski sürümleri ayıklayın, çelişkileri giderin. Bu adım çoğu zaman en uzun süren adımdır.
- Erişim kurallarını belirleyin. Kim hangi belgeyi görebilir? Bu kurallar sisteme baştan girmelidir.
- Veri akışını haritalayın. Hangi veri hangi hizmete, hangi ülkeye gidiyor? KVKK değerlendirmesini bu haritayla yapın.
- Test soruları hazırlayın. Cevabını bildiğiniz 20–30 soruyla sistemi deneyin. Kaynak gösterip göstermediğine ve "bilmiyorum" diyebildiğine bakın.
- Kullanıcı geri bildirimi toplayın. Yanlış cevaplar, hangi belgenin eksik ya da hatalı olduğunu gösterir.
Bilgi tabanı bir yapay zeka ajanına araç olarak da bağlanabilir. Bu durumda ajanın yetki sınırlarıyla ilgili yapay zeka ajanları yazımızdaki ilkeler de geçerli olur.
Bizim deneyimimiz
Kendi ürünlerimizde veri ayrımı ve erişim yetkisi, sonradan eklenen bir özellik değil, mimarinin bir parçası. Su arıtma servis firmaları için geliştirdiğimiz AquaCRM, abonelik modelli bir SaaS ürünüdür ve her abone firma kendi izole veri alanında çalışır. Bir RAG sisteminde de aynı ilke geçerli: Bir firmanın ya da bir kullanıcının belgeleri, başka birinin sorusuna cevap olarak asla dönmemelidir.
Kurumsal bilgi tabanı projelerine bu sırayla bakıyoruz: önce belge düzeni ve erişim kuralları, sonra veri akışının KVKK açısından değerlendirilmesi, en son model ve araç seçimi. Çünkü modeli sonradan değiştirebilirsiniz. Belge düzeni ve yetki tasarımı ise sistemin temelidir.
Sık sorulan sorular
RAG için kendi yapay zeka modelimizi eğitmemiz gerekir mi?
Hayır. RAG'in avantajı, hazır bir modeli yeniden eğitmeden kendi belgelerinizle kullanabilmenizdir. Gerekli olan; belgelerin düzenlenmesi, aranabilir hale getirilmesi ve modelle doğru şekilde bağlanmasıdır.
Genel bir asistana dosya yüklemek ile RAG aynı şey mi?
Benzer bir mantık taşıyabilir: Asistan yüklediğiniz dosyada arama yapıp cevabını ona dayandırabilir. Fark, kurumsal bir RAG sisteminde belgelerin, erişim yetkilerinin, verinin nerede saklandığının ve kayıtların sizin kontrolünüzde olmasıdır. Kişisel veri içeren belgeleri genel bir asistana yüklemeden önce aracın veri politikasını kontrol edin.
RAG halüsinasyonu tamamen önler mi?
Hayır, ama azaltabilir. Model, verilen belge parçalarına dayanarak cevap verdiğinde yanlış bilgi üretme ihtimali düşer. Yine de cevabın kaynağını göstermek, emin olmadığında "bilmiyorum" demesini sağlamak ve kritik cevapları kontrol etmek gerekir.
Ne zaman ince ayar (fine-tuning) gerekir?
Model doğru bilgiye sahip ama işi istediğiniz biçimde, tutarlı olarak yapamıyorsa ince ayarı değerlendirebilirsiniz. Örneğin belirli bir rapor biçimini her seferinde aynı yapıda üretmesi gerekiyorsa. Yeni ya da sık değişen bilgiyi modele öğretmek için ise genelde RAG daha uygundur.
Sonuç
RAG, yapay zekayı kendi verinizle kullanmanın en pratik yollarından biri: Model değişmez, bilgi belgelerinizden gelir, cevaplar kaynak gösterebilir ve belgeyi güncellemek bilgiyi güncellemek için yeterlidir. İnce ayar ise bilgi eklemekten çok davranışı tutarlı hale getirmek için kullanılır. Hangisini seçerseniz seçin, başarıyı belirleyen şey çoğu zaman modelden önce gelir: belgelerin düzeni, erişim kuralları ve kişisel verilerin KVKK'ya uygun işlenmesi.
Kendi belgeleriniz üzerinde çalışan bir bilgi tabanı ya da asistan planlıyorsanız yazılım ve dijital çözümler hizmetimize göz atabilir ya da bizimle iletişime geçebilirsiniz. Yapay zekanın işletmelerdeki genel kullanım alanları için işletmeler için yapay zeka yazımızı da okuyabilirsiniz.
Bu yazı bilgilendirme amaçlıdır, hukuki danışmanlık yerine geçmez.
Kaynaklar7
- Lewis vd., "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks", arXiv:2005.11401 (2020) arxiv.org
- OpenAI, "Optimizing LLM accuracy" (RAG ve ince ayarın hangi sorunları çözdüğü) developers.openai.com
- Kişisel Verileri Koruma Kurumu, "Üretken Yapay Zekâ ve Kişisel Verilerin Korunması Rehberi (15 Soruda)", Kasım 2025 kvkk.gov.tr
- Aynı rehberin PDF metni (ince ayar tanımı, yurt dışına aktarım, aydınlatma, veri sorumlusu ve veri işleyen rolleri) kvkk.gov.tr
- OWASP GenAI Security Project, "LLM01:2025 Prompt Injection" genai.owasp.org
- OWASP GenAI Security Project, "LLM08:2025 Vector and Embedding Weaknesses" genai.owasp.org
- Ren vd., "SoK: Machine Unlearning for Large Language Models", arXiv:2506.09227 (Haziran 2025) arxiv.org